Wie funktioniert KI wie ChatGPT? Sprachmodelle einfach erklärt
Chatbots wie ChatGPT schreiben, indem sie das nächste Textstück vorhersagen. Wie Sprachmodelle trainiert werden und warum sie manchmal etwas erfinden.
Kurze Antwort
KI-Chatbots wie ChatGPT beruhen auf großen Sprachmodellen: riesigen neuronalen Netzen, die mit gewaltigen Textmengen darauf trainiert werden, vorherzusagen, was als Nächstes kommt. Der Text wird in kleine Stücke, sogenannte Tokens, zerlegt; bei jedem Schritt berechnet das Modell, wie wahrscheinlich jedes mögliche nächste Token ist, wählt eines aus, hängt es an und wiederholt den Vorgang. Die meisten modernen Modelle nutzen das 2017 vorgestellte Transformer-Design, das gewichtet, wie jedes Wort mit jedem anderen zusammenhängt. Nach diesem Vortraining werden sie mit von Menschen geschriebenen Beispielen feinabgestimmt und mit menschlichem Feedback angepasst, damit sie Anweisungen folgen und hilfreiche Antworten geben. Weil sie plausiblen Text erzeugen, statt Fakten nachzuschlagen, können sie Falsches selbstsicher behaupten.
In diesem Artikel (8)
Bitten Sie einen Chatbot, Schwarze Löcher zu erklären, eine E-Mail zu entwerfen oder ein Gedicht über Ihre Katze zu schreiben – in Sekunden entsteht flüssiger, oft beeindruckender Text. Werkzeuge wie ChatGPT, Gemini und Claude gehören seit Ende 2022 für Hunderte Millionen Menschen zum Alltag. Aber was passiert eigentlich im Inneren? Denkt der Computer, durchsucht er eine riesige Datenbank oder tut er etwas ganz anderes? Die Antwort ist einfacher und zugleich seltsamer, als viele erwarten.
Die Kernidee: das nächste Stück vorhersagen
Im Herzen eines Chatbots arbeitet ein großes Sprachmodell (Large Language Model, LLM). Seine Grundaufgabe klingt fast zu simpel: Zu einem gegebenen Text vorhersagen, was als Nächstes kommt.
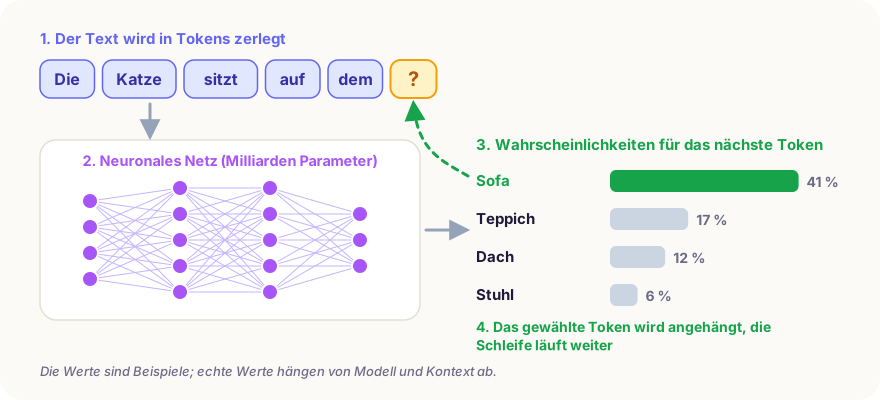
- Ihr Text wird in kleine Stücke zerlegt, die Tokens. Ein Token kann ein kurzes Wort, ein Teil eines längeren Wortes oder ein Satzzeichen sein.
- Das Modell, ein riesiges neuronales Netz, verarbeitet alle bisherigen Tokens.
- Es berechnet für jedes mögliche nächste Token eine Wahrscheinlichkeit. Nach „Die Katze sitzt auf dem“ erhalten Wörter wie „Sofa“ oder „Teppich“ hohe Werte, „Vulkan“ einen sehr niedrigen.
- Ein Token wird ausgewählt, meist eines der wahrscheinlichsten, mit etwas Zufall, damit der Text natürlich klingt.
- Dieses Token wird angehängt, und der ganze Vorgang wiederholt sich, Token für Token, bis die Antwort fertig ist.
Deshalb erscheinen Chatbot-Antworten nach und nach auf dem Bildschirm: Sie entstehen Stück für Stück.
Neuronale Netze und Parameter
Ein neuronales Netz ist eine mathematische Struktur, lose vom Gehirn inspiriert. Es besteht aus Schichten einfacher Einheiten, verbunden durch Parameter – Zahlen, die festlegen, wie stark ein Signal das nächste beeinflusst. Große Sprachmodelle haben Milliarden Parameter.
Zu Beginn des Trainings sind diese Zahlen zufällig und die Vorhersagen Unsinn. Das Training passt sie schrittweise an, bis die Vorhersagen besser werden. Niemand programmiert Grammatikregeln oder Fakten direkt ein; das Modell erfasst Muster über Sprache und Welt selbst aus den Daten.
Der Transformer: Aufmerksamkeit schenken
Die meisten modernen Sprachmodelle nutzen den Transformer, den Google-Forschende 2017 in einem Artikel mit dem einprägsamen Titel Attention Is All You Need vorstellten. Kernstück ist der Aufmerksamkeitsmechanismus (Attention), mit dem das Modell gewichtet, wie relevant jedes Token für jedes andere ist.
Nehmen Sie den Satz: „Der Pokal passte nicht in den Koffer, weil er zu groß war.“ Um gut vorherzusagen, muss das Modell erkennen, dass „er“ den Pokal meint. Attention verknüpft weit auseinanderliegende Wörter und baut Kontext auf. Transformer können zudem viele Tokens parallel verarbeiten – erst das machte es praktikabel, sie mit leistungsstarken Chips auf riesigen Textmengen zu trainieren.
Wie ein Chatbot trainiert wird
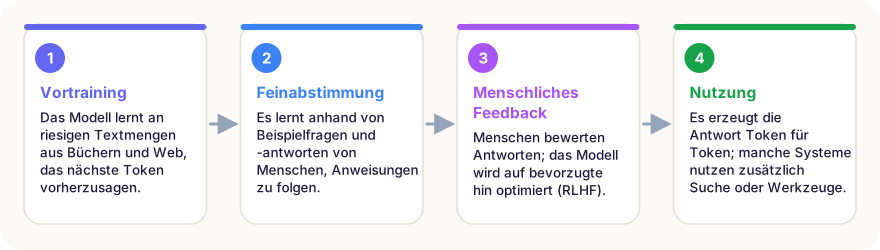
Einen Chatbot zu bauen, umfasst meist mehrere Stufen:
| Stufe | Was passiert | Ergebnis |
|---|---|---|
| Vortraining | Das Modell lernt an riesigen Textmengen aus Büchern, Websites und anderen Quellen, das nächste Token vorherzusagen | Breites Wissen über Sprache und Welt |
| Feinabstimmung | Training mit von Menschen geschriebenen Fragen und guten Antworten | Folgt Anweisungen, antwortet im Gesprächsstil |
| Menschliches Feedback (RLHF) | Menschen vergleichen und bewerten Antworten; das Modell wird auf die bevorzugten hin angepasst | Hilfreichere, ehrlichere und sicherere Antworten |
| Nutzung | Antworten entstehen Token für Token, teils mit Werkzeugen wie Suche | Der Chatbot, mit dem Sie sprechen |
Ein Artikel von Long Ouyang und Kollegen bei OpenAI aus dem Jahr 2022 beschrieb, wie dieses Reinforcement Learning from Human Feedback (RLHF) ein Modell weit besser darin machte, Anweisungen zu befolgen. In ihren Tests bevorzugten Menschen die Antworten eines deutlich kleineren, so trainierten Modells gegenüber denen eines viel größeren Modells ohne dieses Training.
Was Chatbots gut können
Sprachmodelle sind stark bei Aufgaben, die auf sprachlichen Mustern beruhen:
- Begriffe in einfachen Worten erklären,
- Texte zusammenfassen und übersetzen,
- E-Mails, Aufsätze und Code entwerfen und überarbeiten,
- Ideen sammeln und Nachfragen beantworten.
Viele Denkaufgaben können sie Schritt für Schritt lösen, besonders neuere Modelle, die darauf trainiert sind, vor der Antwort „nachzudenken“.
Ihre Grenzen
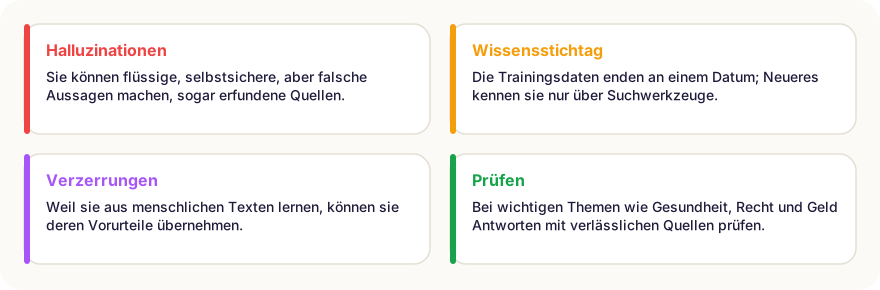
Weil ein Sprachmodell plausiblen Text erzeugt, statt Fakten nachzuschlagen, hat es wichtige Schwächen:
- Halluzinationen: Es kann selbstsichere, flüssige, aber schlicht falsche Aussagen machen, inklusive Zitaten oder Quellen, die es nicht gibt.
- Wissensstichtag: Die Trainingsdaten enden an einem bestimmten Datum. Ohne Suchwerkzeug kennt es spätere Ereignisse nicht.
- Verzerrungen: Weil es aus menschlichen Texten lernt, kann es deren Vorurteile widerspiegeln, auch wenn Entwickler das zu verringern versuchen.
- Keine eingebaute Faktenprüfung: Es gleicht seine Aussagen nicht automatisch mit verlässlichen Quellen ab.
Bei wichtigen Themen wie Gesundheit, Recht, Geld oder Sicherheit sollten Sie Chatbot-Antworten als Ausgangspunkt sehen und mit vertrauenswürdigen Quellen oder Fachleuten prüfen.
Ist das wirklich intelligent?
Ob Sprachmodelle Sprache „verstehen“, ist eine der lebhaftesten Debatten in Wissenschaft und Philosophie. Sie erfassen offensichtlich sehr viel Wissen und lösen Aufgaben, die ihnen nie ausdrücklich gezeigt wurden. Zugleich funktionieren sie ganz anders als der menschliche Geist: Sie lernen aus Text statt aus dem Leben in der Welt und können auf eine Weise scheitern, wie es kein Mensch täte. In einem sind sich die meisten Forschenden einig: Diese Systeme sind mächtige Werkzeuge, deren Fähigkeiten und Grenzen noch vermessen werden.
Kurz gesagt
- Chatbots laufen auf großen Sprachmodellen, die das nächste Token vorhersagen.
- Text wird in Tokens zerlegt; das Modell wählt eines nach dem anderen.
- Die meisten Modelle nutzen den Transformer von 2017, aufgebaut um Attention.
- Das Training umfasst Vortraining, Feinabstimmung und menschliches Feedback (RLHF).
- Sie können halluzinieren, haben einen Wissensstichtag und können Verzerrungen zeigen.
- Nutzen Sie sie als Helfer, aber prüfen Sie wichtige Antworten.
Häufige Fragen
Durchsucht ChatGPT das Internet?
Ein Sprachmodell allein tut das nicht; es antwortet aus Mustern, die es im Training gelernt hat. Manche Chatbot-Produkte ergänzen ein Suchwerkzeug, das Webseiten abruft und dem Modell übergibt, und weisen meist darauf hin.
Warum machen KI-Chatbots Fehler?
Sie sind darauf trainiert, wahrscheinlich klingenden Text zu erzeugen, nicht Fakten zu prüfen. Sind die Trainingsdaten dünn, widersprüchlich oder veraltet, können sie „halluzinieren“: flüssige, aber falsche Antworten, manchmal mit erfundenen Quellen.
Versteht KI, was sie sagt?
Das ist umstritten. Sprachmodelle erfassen viel über Sprache und Welt und können viele Probleme durchdenken, funktionieren aber ganz anders als menschliche Gehirne. Forschende sind uneins, wie man ihr „Verstehen“ beschreiben soll.
Was ist ein Token?
Ein Token ist ein kleines Textstück, oft ein kurzes Wort, ein Teil eines längeren Wortes oder ein Satzzeichen. Sprachmodelle lesen und schreiben in Tokens, und ihre Grenzen werden oft in Tokens gemessen.
Quellen
- Vaswani et al. (2017) – Attention Is All You Need, arXiv
- Ouyang et al. (2022) – Training language models to follow instructions with human feedback, arXiv
Dieser Artikel basiert auf begutachteter Forschung und Veröffentlichungen vertrauenswürdiger Institutionen und wird regelmäßig überprüft. So arbeiten wir →
Das könnte dich auch interessieren
Alle in Wie funktioniert das? →
Wie funktioniert das Internet? Datenpakete, Kabel und die Reise einer Webseite
Beim Öffnen einer Website reisen Daten in Millisekunden durch Kabel, Router und Ozeane. Wie DNS, IP, TCP und Seekabel eine Webseite zu dir bringen.
Wie funktioniert ein Elektroauto? Akku, Motor, Laden und Reichweite erklärt
Elektroautos haben keinen Tank und kein Schaltgetriebe. Wie Akku, Wechselrichter und Motor arbeiten, warum E-Autos so effizient sind und wie Laden funktioniert.
Wie fliegt ein Flugzeug? Auftrieb, Flügel und ein berühmter Irrtum
Ein Jumbojet wiegt Hunderte Tonnen und bleibt doch in der Luft. Wie Flügel Auftrieb erzeugen und warum eine beliebte Erklärung falsch ist.
Wie funktioniert ein Touchscreen? Warum der Finger klappt und der Handschuh nicht
Handydisplays spüren den Finger über ein unsichtbares Gitter. Wie kapazitive Touchscreens und Multitouch funktionieren und warum Handschuhe scheitern.
Wie funktioniert GPS? Satelliten, Atomuhren und Einstein
Dein Handy ortet sich mit Satelliten in 20.000 km Höhe. Wie GPS Signallaufzeiten nutzt, warum es vier Satelliten braucht und warum Einstein zählt.
Wie funktioniert ein QR-Code? Die Quadrate, die Links und Text speichern
Ein QR-Code speichert Daten als Raster aus schwarzen und weißen Quadraten. Wozu die Eckquadrate dienen und warum beschädigte Codes lesbar bleiben.